PINNの基礎理論
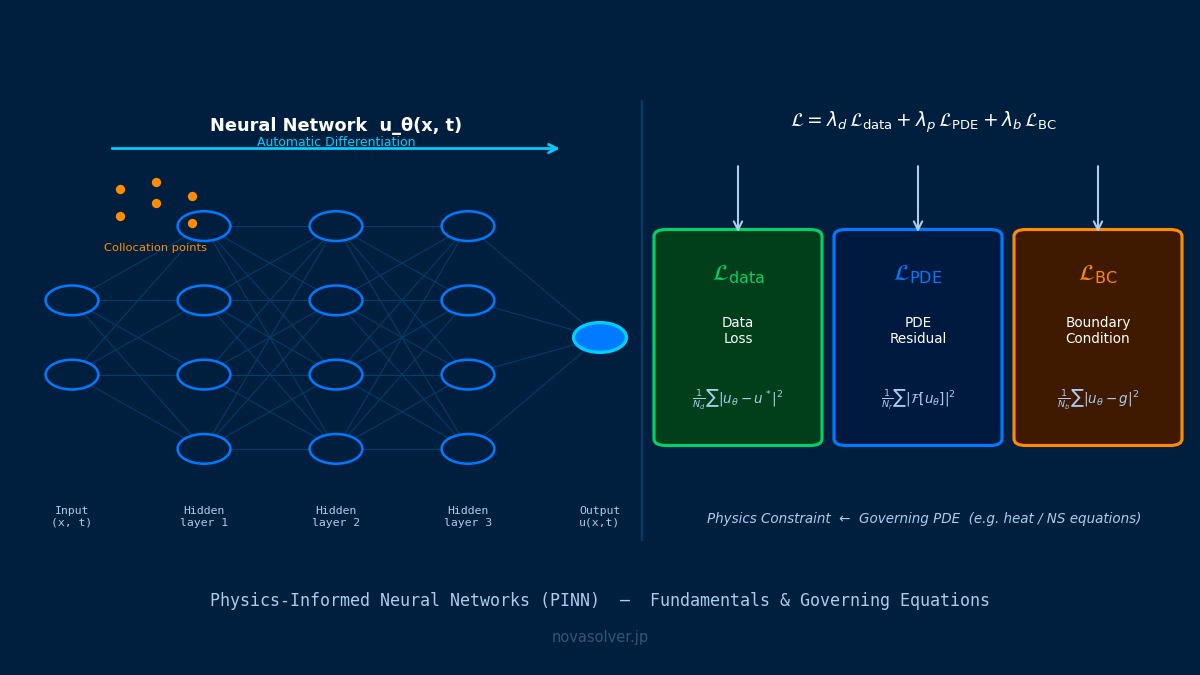
理論:方程式を損失関数に入れる
概要
PINNはデータがなくても学習できると聞きました。何を手がかりに学習するのですか?
支配方程式そのものだ。普通のニューラルネットワークは入力と正解の組(データ)との差を小さくするように学習するが、PINNでは、ネットワークが表す関数 u(x) を方程式に代入したときの残差を損失関数にする。微分は自動微分で正確に計算できるので、領域の中に散らばせた選点(コロケーション点)で残差を評価し、境界条件や初期条件のずれと合わせて最小化する。測定データがあれば、それとのずれも同じ損失関数に足せる。メッシュを作らなくてよく、方程式とデータを一つの枠組みで扱えるのが魅力だ。ただし、学習で損失が下がることと、解が正しいことは別で、選点の数と配置、各項の重みの付け方、変数のスケールの揃え方で結果が大きく変わる。
PINNの損失関数
θ はネットワークのパラメータ、𝒩 は微分作用素(例えば u″)、f は右辺、x_i は選点、g は境界の値、λ_b・λ_d は境界とデータの項の重み、L_data は測定データとのずれ。
1990年代のアイデアの復活
ニューラルネットワークで微分方程式を解く考え方自体は、1998年のLagarisらの論文などで既に示されていた。それが2017〜2019年にRaissi、Perdikaris、Karniadakisの研究で「PINN」として広まったのは、自動微分を備えたTensorFlowやPyTorchが普及し、方程式の残差を簡単に損失関数に書けるようになったからだ。古いアイデアが、道具の進歩で一気に実用的になった例と言える。
計算例
表は通常の全層学習PINNではなく、物理情報付きランダム特徴の最小二乗例。隠れ層60・乱数seed 0・重みとバイアス各[-8,8]・等間隔選点・境界重み1。独立評価は[0,1]の1,001点で、残差列はRMS、解の誤差は最大絶対値。ライブラリの丸めやseedにより値は変わる。
例:u″ = −π² sin(πx)、u(0) = u(1) = 0(厳密解 sin(πx))
隠れ層1層・60個のtanhのネットワーク(隠れ層の重みは乱数で固定し、出力層を最小二乗で決める物理情報付きランダム特徴モデル)で、選点の数を変えた。
| 選点の数 | 選点での残差 | 選点の間の残差 | 解の最大誤差 |
|---|---|---|---|
| 5 | 6.7×10⁻¹⁵ | 9.3 | 0.75 |
| 10 | 2.6×10⁻¹⁴ | 0.87 | 5.3×10⁻³ |
| 20 | 1.4×10⁻¹⁴ | 1.4×10⁻³ | 4.0×10⁻⁶ |
| 50 | 5.5×10⁻¹⁰ | 7.6×10⁻⁹ | 6.4×10⁻¹² |
選点が5点のときは、選点での残差はほぼゼロ(損失は最小)なのに、選点の間では方程式をまったく満たしておらず、解は大きく外れている。ネットワークの自由度が選点の数より多いと、選点だけを満たす答えがいくらでも作れるためだ。
PyTorchでPINNを学習させると、損失は順調に下がるのに、境界の値がいつまでも合いません。どうすればよいですか?
損失の各項の大きさがそろっていない可能性が高い。方程式の残差の項は、2階微分を含むので値の桁が大きく、勾配降下法では残差を減らす方向ばかりに引っ張られて、境界の項がなかなか減らない。対策はいくつかある。境界の項の重み λ_b を大きくする、学習中に各項の勾配の大きさを見て重みを自動で調整する方法を使う、境界条件を満たすようにネットワークの出力を変形する(例えば u = x(1−x)·NN(x) とすれば u(0) = u(1) = 0 が必ず成り立つ)、などだ。最後の方法は境界の項そのものが不要になるので最も確実だ。また、入力の座標や出力の値を0〜1程度に正規化しないと、活性化関数が飽和して学習が進まない。学習が終わったら、選点以外の細かい点で残差と、可能なら既知解や FEM との差を確かめよう。
実務での進め方
- 解きたい問題が順問題か逆問題かを確認し、FEMで足りるならFEMを使う。
- 座標と変数を無次元化・正規化し、損失の各項の大きさをそろえる。
- 可能な境界条件はネットワークの出力の形で満たし、残りを損失に入れる。
- 選点を十分に、変化の大きい所には多めに置き、学習に使わない点で残差を確かめる。
- 既知解やFEMの結果と比べて精度を確かめてから、逆問題やデータ融合に使う。
「損失の曲線だけ見ていた」
PINNの学習では、損失の曲線が下がっていくのを見ると安心しがちだ。しかし、損失は選点での値なので、選点を増やして同じ学習をやり直すと、損失が急に大きくなることがある。それは前の解が選点の間で方程式を満たしていなかった証拠だ。損失の曲線と並べて、学習に使っていない点での残差を定期的に記録しておくと、こうした見かけの収束にすぐ気づける。
よくある間違い
間違いと対策
| 間違い | 起きること | 対策 |
|---|---|---|
| 選点が少ない | 見かけの収束 | 学習外の点で残差を確認 |
| 損失の項の桁が違う | 境界条件が満たされない | 重み調整・出力の変形 |
| 正規化しない | 学習が進まない | 0〜1程度に揃える |
| FEMで足りる順問題に使う | 遅く不正確 | 目的で使い分け |
| 既知解で確かめない | 誤差に気づかない | FEM・解析解と比較 |
関連する内容も知りたいです。
関連するページはPINNによる逆問題解析、PINN熱伝導解析、DeepONet演算子学習、フーリエニューラル演算子(FNO)が参考になる。
よくある質問
PINNとは何ですか?
ニューラルネットワークで解 u(x) を表し、支配方程式の残差と境界条件・初期条件のずれを損失関数に入れて学習させる方法です。微分は自動微分で計算するのでメッシュが要らず、測定データも同じ損失関数に加えられます。2019年にRaissiらが体系的に示して広まりました。
損失が小さくなれば、解は正しいのですか?
そうとは限りません。損失は選点(残差を評価する点)でしか計算されないからです。u″ = −π² sin(πx) の例では、選点5点で残差が10⁻¹⁴とほぼゼロになっても、解の最大誤差は0.75で、選点の間の残差は9.3もありました。選点を20点にすると誤差は4×10⁻⁶になります。学習に使わない点で残差と誤差を確かめることが欠かせません。
PINNはFEMの代わりになりますか?
順問題(条件が決まっている問題を解く)では、多くの場合FEMのほうが速く正確です。PINNが力を発揮するのは、測定データから材料定数や境界条件を推定する逆問題や、測定とモデルを融合する場面、高次元の問題などです。目的に応じて使い分けるのが現実的です。
参考資料・検算の位置づけ
掲載値は本文の仮定に基づく教育用の参考計算。資料は理論・設定の参照先であり、本記事の数値を各ソフトで再現した証明ではない。設計・製造の判断には対象条件での検証が必要。
関連トピック
なった
詳しく
報告