PINN基础理论
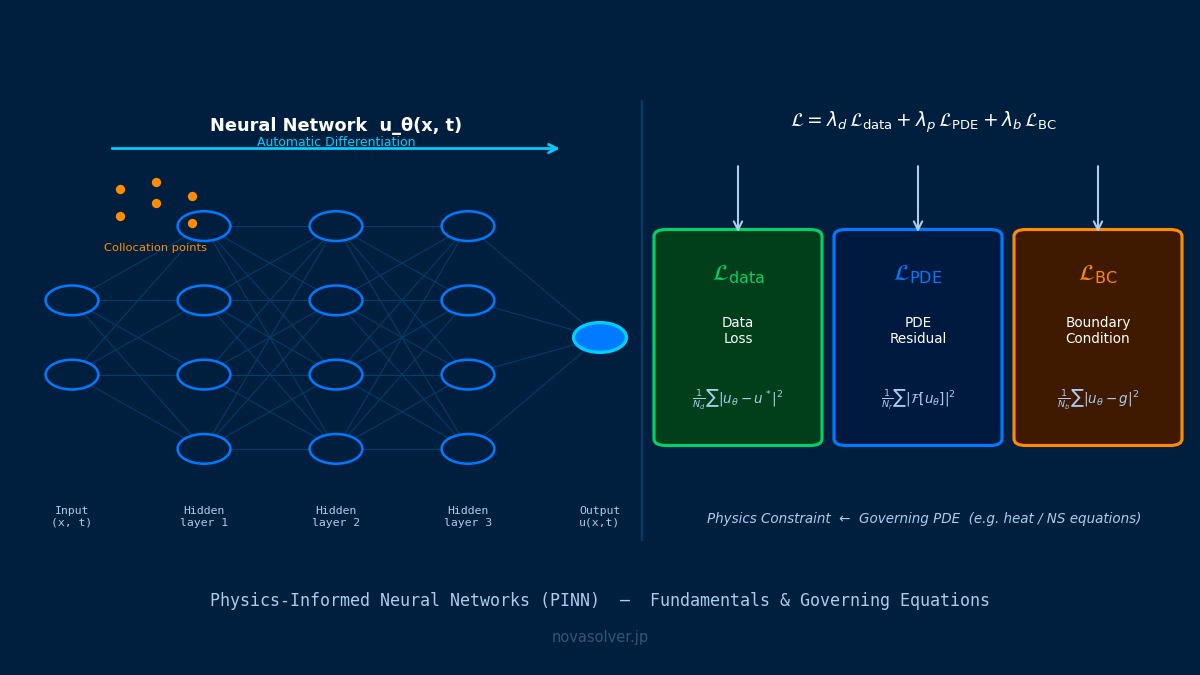
理论:把方程放进损失函数
概述
听说PINN没有数据也能训练。它靠什么来学习?
靠控制方程本身。普通神经网络通过缩小与输入-正解对(数据)的差来学习,而PINN把网络所表示的函数u(x)代入方程后的残差作为损失函数。导数可以用自动微分精确计算,因此在求解域中散布的配点(collocation点)上评估残差,并与边界、初始条件的偏差一起最小化。有测量数据时,与数据的偏差也可以加入同一个损失函数。不需要生成网格、能在一个框架中同时处理方程和数据,是它的魅力所在。但训练中损失下降与解正确是两回事,配点的数量和分布、各项权重的设置、变量尺度的统一方式都会大大改变结果。
PINN的损失函数
θ为网络参数,𝒩为微分算子(如u″),f为右端项,x_i为配点,g为边界值,λ_b、λ_d为边界项和数据项的权重,L_data为与测量数据的偏差。
1990年代想法的复兴
用神经网络求解微分方程的想法本身,在1998年Lagaris等人的论文中就已经提出。它在2017〜2019年因Raissi、Perdikaris、Karniadakis的研究以“PINN”之名流行开来,是因为具备自动微分功能的TensorFlow、PyTorch普及,使方程残差能方便地写进损失函数。这是一个老想法因工具进步而一下子变得实用的例子。
算例
这是物理信息随机特征的最小二乘例,不是全层训练的PINN。使用60个隐藏单元、seed 0、[-8,8]随机权重与偏置、均匀配点、边界权重1。独立网格为[0,1]上1,001点;残差为RMS,解误差为最大绝对误差。舍入及随机种子会改变数值。
例:u″ = −π² sin(πx),u(0) = u(1) = 0(精确解sin(πx))
使用单隐藏层、60个tanh单元的网络(隐藏层权重随机固定、输出层用最小二乘确定的物理信息随机特征模型),改变配点数量。
| 配点数 | 配点处残差 | 配点之间的残差 | 解的最大误差 |
|---|---|---|---|
| 5 | 6.7×10⁻¹⁵ | 9.3 | 0.75 |
| 10 | 2.6×10⁻¹⁴ | 0.87 | 5.3×10⁻³ |
| 20 | 1.4×10⁻¹⁴ | 1.4×10⁻³ | 4.0×10⁻⁶ |
| 50 | 5.5×10⁻¹⁰ | 7.6×10⁻⁹ | 6.4×10⁻¹² |
5个配点时,配点处残差几乎为零(损失最小),但在配点之间完全不满足方程,解偏差很大。网络自由度多于配点数时,只满足这些配点的答案可以有无数个。
用PyTorch训练PINN,损失顺利下降,边界值却一直对不上。该怎么办?
很可能是损失各项的量级不一致。方程残差项含二阶导数,数值量级大,梯度下降几乎都被拉向减小残差的方向,边界项很难减小。对策有几种:增大边界项权重λ_b;使用在训练中监测各项梯度大小并自动调整权重的方法;对网络输出做变换使其自动满足边界条件(例如令u = x(1−x)·NN(x),则u(0) = u(1) = 0必然成立)。最后一种连边界项都不需要了,最为可靠。另外,输入坐标和输出值若不归一化到0〜1左右,激活函数会饱和,训练无法推进。训练结束后,要在配点以外的细密点上检查残差,可能的话再与已知解或有限元比较。
实务流程
- 确认要解的是正问题还是反问题,有限元够用就用有限元。
- 对坐标和变量无量纲化、归一化,使损失各项量级一致。
- 能满足的边界条件通过网络输出形式满足,其余放入损失函数。
- 配点要充足,变化大的地方多放,并在未参与训练的点上检查残差。
- 先与已知解或有限元结果比较确认精度,再用于反问题或数据融合。
“只盯着损失曲线”
训练PINN时,看到损失曲线下降容易让人放心。但损失是配点上的值,增加配点重新训练时损失可能突然变大,这正说明之前的解在配点之间并不满足方程。在损失曲线旁定期记录未参与训练的点上的残差,就能立刻发现这种假收敛。
常见错误
错误与对策
| 错误 | 后果 | 对策 |
|---|---|---|
| 配点太少 | 假收敛 | 在训练外的点检查残差 |
| 损失项量级不同 | 边界条件不满足 | 调整权重或变换输出 |
| 不做归一化 | 训练停滞 | 缩放到0〜1左右 |
| 把PINN用于有限元就够的正问题 | 慢且不准 | 按目的选用 |
| 不用已知解检验 | 发现不了误差 | 与有限元或解析解比较 |
我想了解相关内容。
常见问题
PINN是什么?
用神经网络表示解u(x),把控制方程的残差以及边界、初始条件的偏差放入损失函数进行训练的方法。导数由自动微分计算,不需要网格,测量数据也能加入同一个损失函数。2019年Raissi等人系统阐述后得到广泛应用。
损失变小,解就正确吗?
不一定,因为损失只在配点(评估残差的点)上计算。u″ = −π² sin(πx)的例子中,用5个配点时残差为10⁻¹⁴几乎为零,解的最大误差却是0.75,配点之间的残差高达9.3;用20个配点误差降到4×10⁻⁶。在不参与训练的点上检查残差和误差必不可少。
PINN能代替有限元吗?
对于正问题(条件已定的求解),多数情况下有限元更快更准。PINN擅长的是由测量数据推断材料常数或边界条件的反问题、测量与模型融合的场景以及高维问题。按目的分工使用比较现实。
参考资料与检验范围
所列数值是基于文中假设的教学参考计算。资料用于理论和设置参考,不证明已在各软件中复现这些数值。工程决策须按实际条件验证。